Imagen a vídeo
Generador de vídeos de Halloween con IA
Genera primero la imagen fija y luego anímala. El movimiento corto y contenido funciona mejor: un giro de cabeza, niebla que avanza, un pulso de luz o un push-in lento. Así la cara y el disfraz se mantienen estables.
- Clips de cinco segundos desde un retrato terminado
- Prompts de movimiento para cabeza, niebla y luz
- Rutas de Kling, Wan y Fal en un mismo espacio
Actualizado el 20 de octubre de 2026
Looks de Halloween relacionados
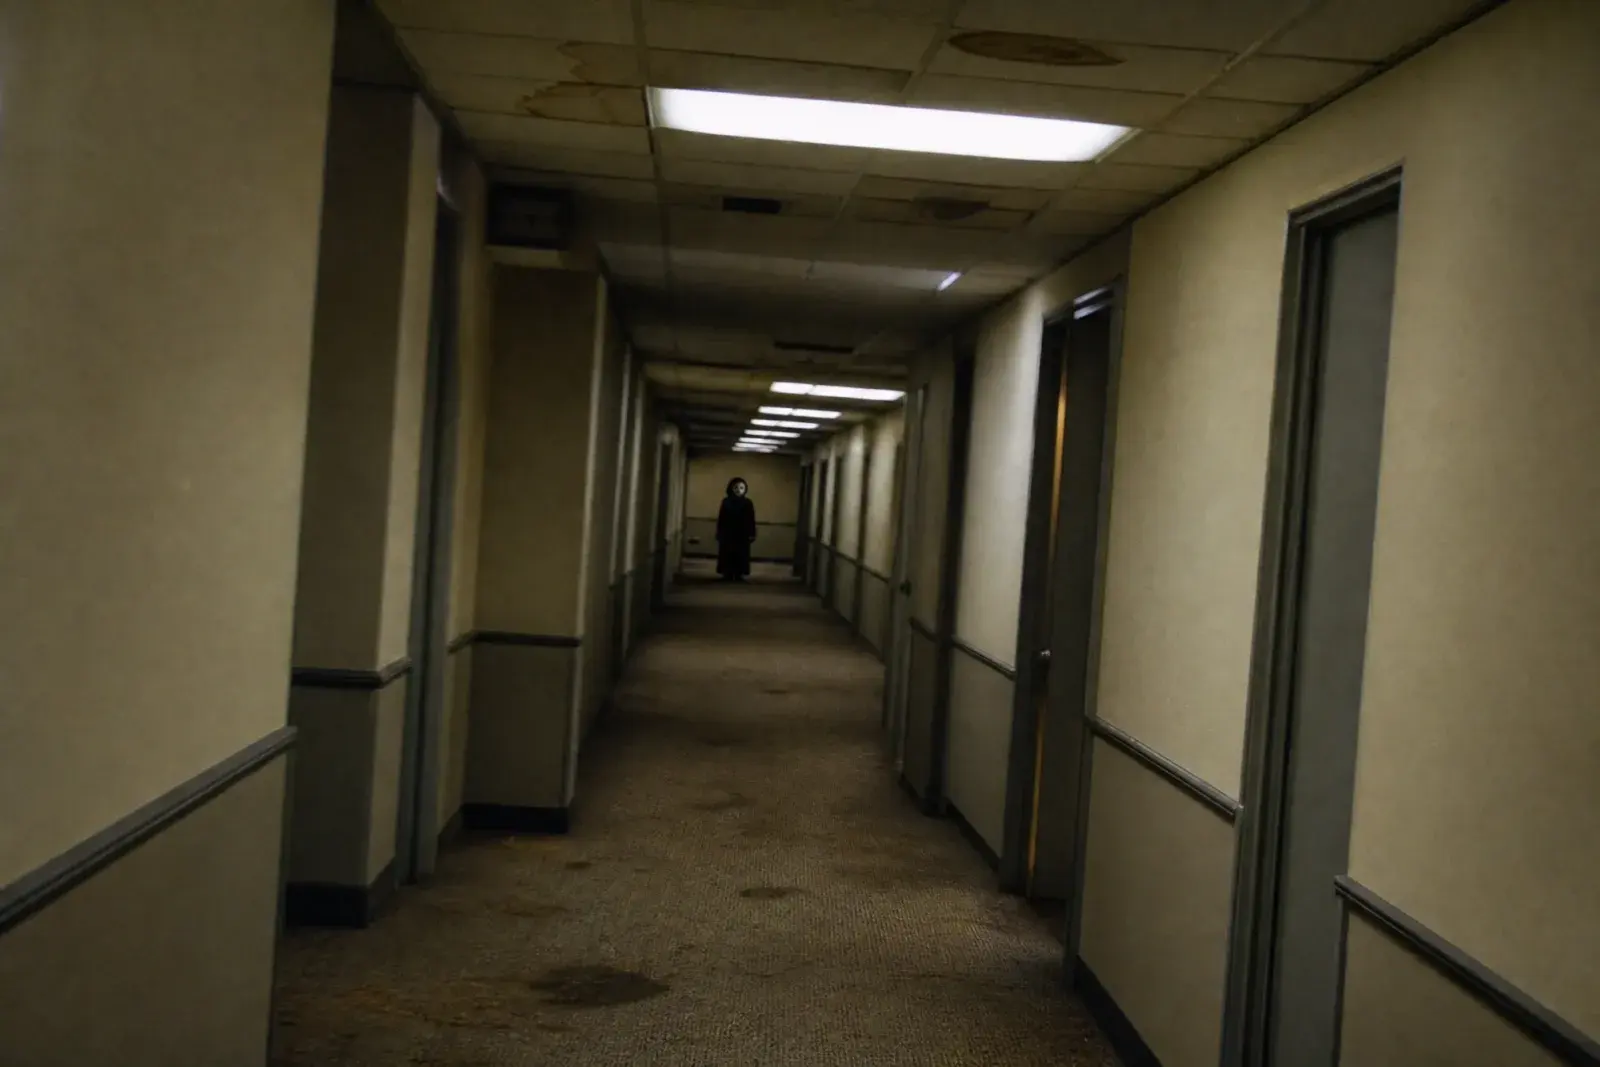
Ocho looks originales construidos con el lenguaje de disfraces de este año: trenzas góticas, princesa celestial, héroe con visor, mascota calabaza, robot, mascota embrujada, terror liminal y pareja cowboy-ángel.
Cómo funciona
1
Sube una foto clara
Mejor de frente, con luz uniforme y sin gafas de sol. Una persona funciona mejor; para dos hace falta un modelo multi-referencia.
2
Mantén las líneas de identidad
El prompt protege la cara, el tono de piel, las proporciones y el número de personas. Cambia el vestuario y la escena, no a la persona.
3
Edita primero, anima después
Genera la imagen fija. Cuando la cara y el vestuario estén bien, envía esa imagen a un modelo de imagen a vídeo para un clip de cinco segundos.
Receta del prompt
Usa este prompt de movimiento cuando la imagen fija ya esté bien. Conserva las líneas de identidad y vestuario; cambia solo el movimiento y la dirección de cámara.
Abre el generador de imágenes, sube tu foto y conserva las líneas que protegen la identidad. El prompt está escrito para un modelo de edición, no para un texto-a-imagen genérico.
Cinematic still from an original liminal-space Halloween video: a long empty office corridor with damp beige carpet, stained ceiling tiles, buzzing fluorescent lights, and a distant figure in a simple dark costume standing at the far end. The figure is small and ambiguous, not gory. Handheld camera perspective, slight motion blur, realistic fluorescent color cast, film grain. No text, no logos, no watermark. Do not reproduce a specific film or game scene.
Rutas de modelo
Cada look puede ejecutarse en más de un modelo. Empieza por un modelo que priorice la identidad y compara después una edición de escena si necesitas más fuerza en el vestuario o el fondo.
KIENano Banana ProConservar cara e identidad
Edición de imagenKIESeedream 4.5 EditVestuario, tejido y escena
Edición de imagenKIEFLUX KontextVestuario, tejido y escena
Edición de imagenKIEGPT-4o Image EditVestuario, tejido y escena
Edición de imagenKIEKling 2.1 ProMovimiento cinematográfico corto
Imagen a vídeoKIEVeo 3.1 FastMovimiento cinematográfico corto
Imagen a vídeoKIESeedance 1.5 ProMovimiento cinematográfico corto
Imagen a vídeoKIESora 2 CharactersMovimiento cinematográfico corto
Imagen a vídeoPreguntas
¿Debo animar la foto original o la imagen generada?+
Anima la imagen generada. El disfraz y la escena ya están resueltos, así el modelo de vídeo solo tiene que gestionar el movimiento en lugar de inventar el look y el movimiento a la vez.
¿Qué movimiento es más fácil de controlar?+
Empieza con un giro leve de cabeza, un parpadeo, niebla que avanza o un push-in lento. Evita caminar, gestos con las manos y movimientos rápidos de cámara hasta que el primer clip sea estable.
¿Por qué cambia la cara entre fotogramas?+
El movimiento largo o complejo da más oportunidades al modelo para desviarse. Acorta el clip, simplifica el prompt y repite la restricción de identidad en el prompt de movimiento.
Generador de vídeos de Halloween con IA
Genera la imagen fija. Cuando la cara y el vestuario estén bien, envía esa imagen a un modelo de imagen a vídeo para un clip de cinco segundos.
Interpretaciones originales con IA. Vidle no está afiliado a los titulares de derechos de películas, juegos o disfraces. Sube solo fotos de personas que te hayan dado permiso.