Immagine in video
Generatore video Halloween IA
Genera prima il fermo immagine, poi animalo. Il movimento breve e trattenuto funziona meglio: una leggera rotazione della testa, nebbia, un impulso di luce o un lento push-in.
- Clip di cinque secondi da un ritratto finito
- Prompt movimento per testa, nebbia e luce
- Percorsi Kling, Wan e Fal in un unico spazio
Aggiornato il 20 ottobre 2026
Look di Halloween correlati
Parti da una foto, scegli un look originale e genera un ritratto costume che puoi modificare o animare. Ogni look include un prompt testato e un percorso modello.
Come funziona
1
Carica una foto nitida
Meglio frontale, con luce uniforme e senza occhiali da sole. Una persona funziona meglio; per due serve un modello multi-reference.
2
Mantieni le righe di identità
Il prompt protegge viso, carnagione, proporzioni e numero di persone. Cambia costume e scena, non la persona.
3
Prima modifica, poi anima
Genera prima l’immagine fissa. Quando viso e costume sono giusti, inviala a un modello image-to-video per un clip di cinque secondi.
Ricetta del prompt
Usa questo prompt quando il fermo immagine è buono. Mantieni identità e costume; cambia solo movimento e camera.
Apri il generatore di immagini, carica la foto e mantieni le righe che proteggono l’identità. Il prompt è scritto per un modello di editing, non per un text-to-image generico.
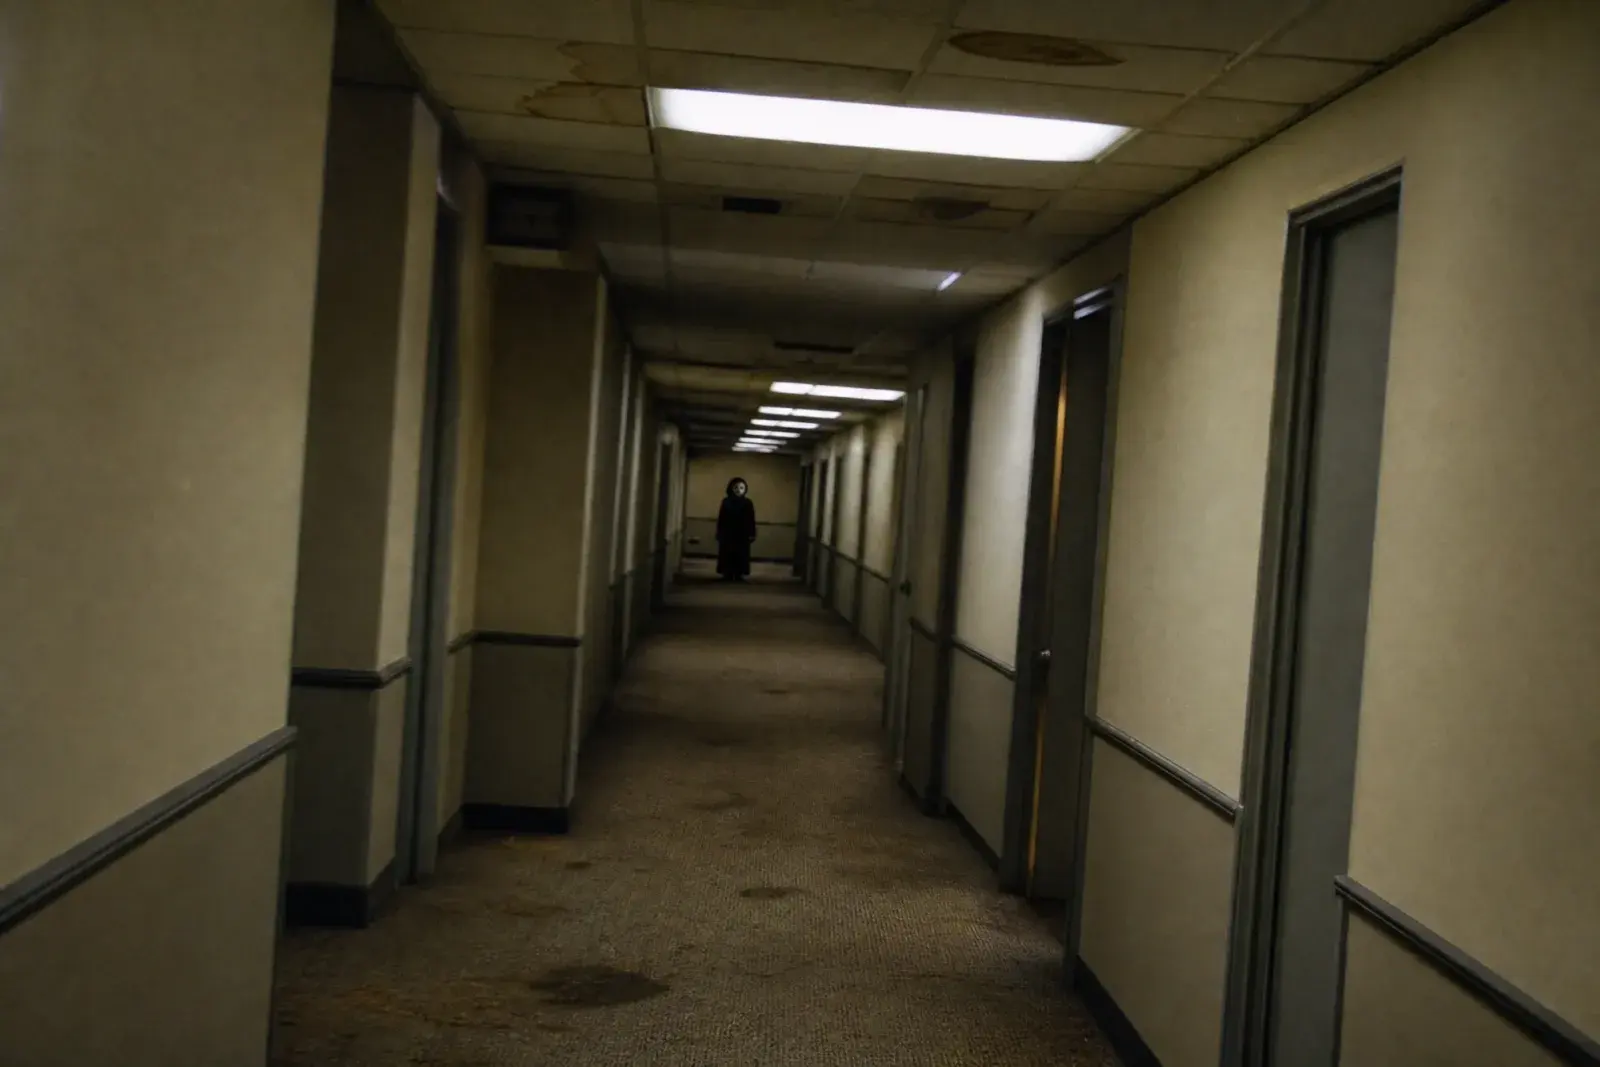
Cinematic still from an original liminal-space Halloween video: a long empty office corridor with damp beige carpet, stained ceiling tiles, buzzing fluorescent lights, and a distant figure in a simple dark costume standing at the far end. The figure is small and ambiguous, not gory. Handheld camera perspective, slight motion blur, realistic fluorescent color cast, film grain. No text, no logos, no watermark. Do not reproduce a specific film or game scene.
Routing dei modelli
Ogni look può girare su più provider. Inizia con un modello che privilegia l’identità, poi confronta un editing orientato alla scena.
KIENano Banana ProViso e identità preservati
Editing immagineKIESeedream 4.5 EditCostume, tessuto e scena
Editing immagineKIEFLUX KontextCostume, tessuto e scena
Editing immagineKIEGPT-4o Image EditCostume, tessuto e scena
Editing immagineKIEKling 2.1 ProMovimento cinematografico breve
Immagine in videoKIEVeo 3.1 FastMovimento cinematografico breve
Immagine in videoKIESeedance 1.5 ProMovimento cinematografico breve
Immagine in videoKIESora 2 CharactersMovimento cinematografico breve
Immagine in videoDomande
Devo animare la foto originale o l immagine generata?+
Anima l immagine generata. Costume e scena sono gia risolti, quindi il modello video deve gestire solo il movimento.
Quale movimento è più facile da controllare?+
Inizia con una leggera rotazione della testa, un battito di ciglia, nebbia o un lento push-in. Evita camminate e gesti rapidi.
Perche il viso cambia tra i frame?+
Movimenti lunghi o complessi danno più occasioni al modello di derivare. Accorcia il clip e semplifica il prompt.
Generatore video Halloween IA
Genera prima l’immagine fissa. Quando viso e costume sono giusti, inviala a un modello image-to-video per un clip di cinque secondi.
Interpretazioni originali con IA. Vidle non è affiliata ai titolari dei diritti di film, giochi o costumi. Carica solo foto di persone che hanno dato il consenso.